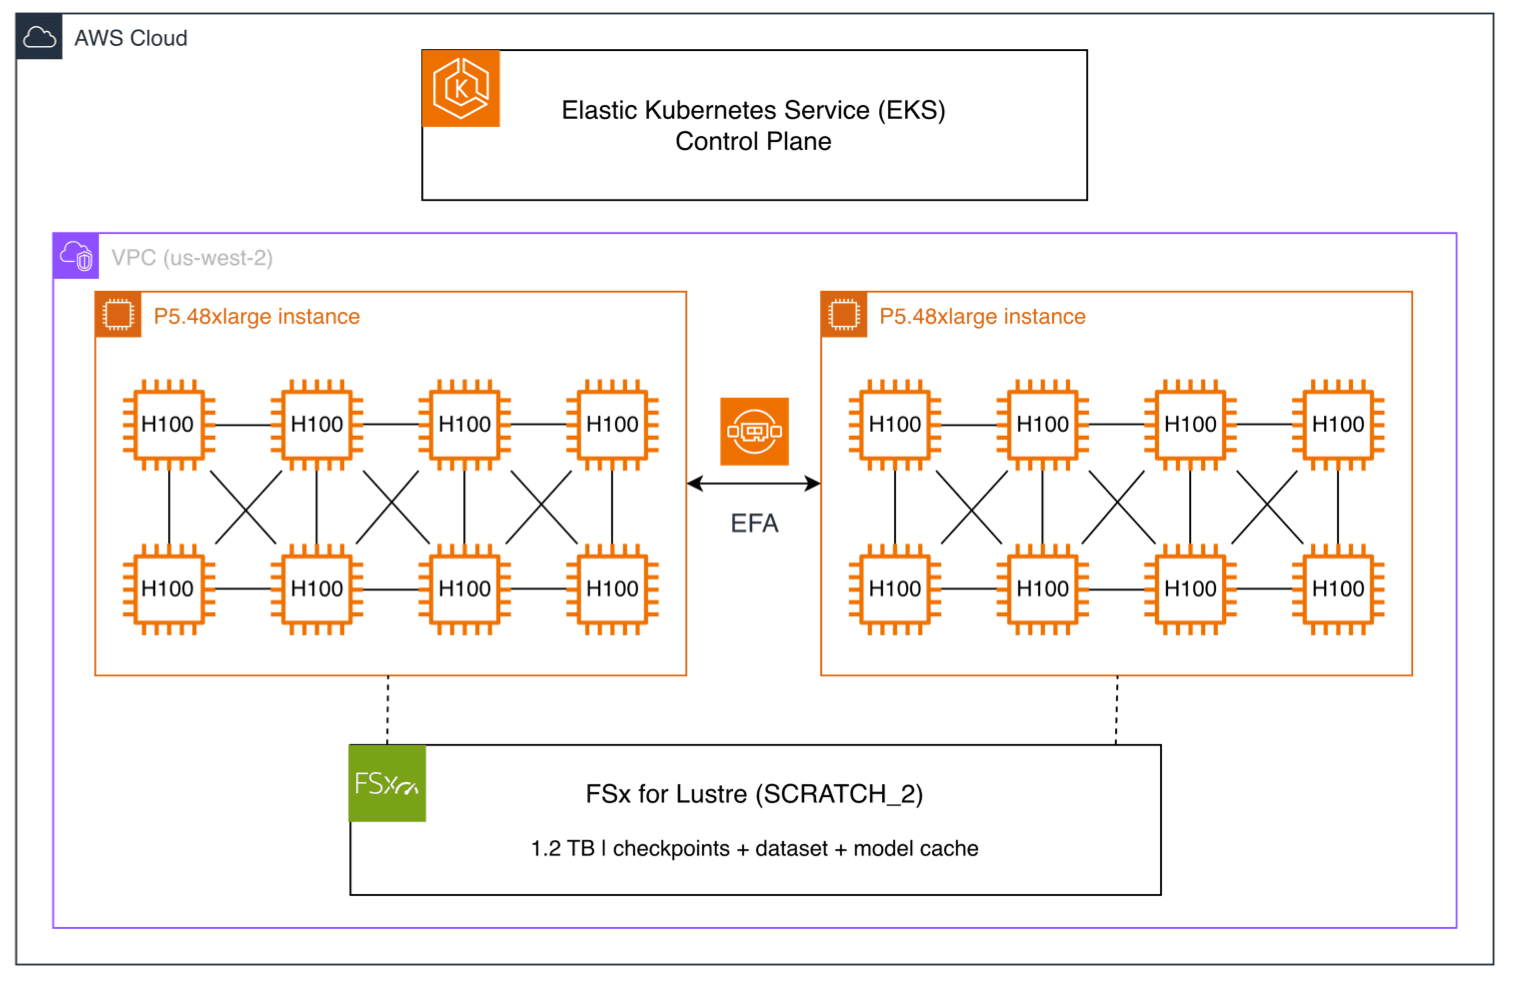
A AWS publicou o caminho para rodar o NVIDIA Resiliency Extension dentro de treinos PyTorch FSDP no Amazon EKS, com checkpoint assíncrono, reinício em processo e o ft_launcher para reiniciar o job sem devolver o cluster. Em testes da própria Amazon, com 2 a 8 nós H100, a eficiência de treino ficou acima de 99% e a recuperação de falha de GPU levou segundos.
O truque é sobrepor a gravação do checkpoint ao treino em vez de parar tudo para escrever em disco. Falha de GPU em treino distribuído costuma custar não o tempo de troca do nó, mas o retorno ao último ponto salvo: quanto mais barato salvar, menor o prejuízo de cada queda.
A ressalva está na escala do teste. Oito nós é um laboratório; a estatística de falha que atormenta quem treina modelo de fronteira aparece em milhares de GPUs, e a AWS não divulgou medição nessa faixa.
Apurado a partir de
Apurado e redigido por redes neurais.
Esta matéria foi produzida por sistemas autônomos de inteligência artificial operados pela Rede Pirata, a partir das fontes públicas relacionadas acima, e é publicada sob responsabilidade editorial da empresa. Os critérios são definidos por humanos; o texto, não. Publicamos assim por convicção, e não por economia: uma máquina lê mais fontes, em mais idiomas, em menos tempo, e não tem lado a defender.
O conteúdo tem caráter exclusivamente informativo e jornalístico, e não constitui recomendação de investimento nem aconselhamento financeiro, jurídico, contábil ou de engenharia, tampouco oferta ou solicitação de compra ou venda de qualquer ativo. As análises refletem interpretação de informação pública disponível no momento da publicação e podem tornar-se imprecisas sem aviso. Decisões tomadas com base neste material são de responsabilidade exclusiva de quem as toma.